Documentació: El nou marc explicat
Documentació: El nou marc explicat
El nou mòdul de documentació pretén ser un bon company per a usuaris, desenvolupadors, redactors de documentació i traductors. Per tant, vegeu els diferents aspectes del marc.
Com es veu
En primer lloc, us mostraré com es veu la documentació dins de Koo i què es pot fer amb ella. Com ja he esmentat, esperem que els clients Web i GTK s'hi uneixin, de manera que el que ja tenim a Koo hauria d'estar disponible també en aquests clients.
Comencem per la part senzilla. Hem creat tres opcions de submenú dins de Ajuda/Documentació.
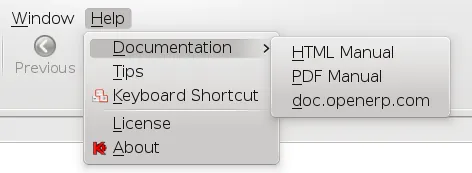
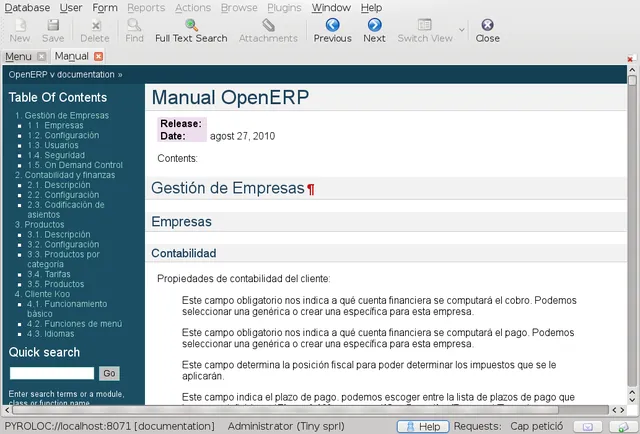
La primera obrirà la documentació en una pestanya nova de l'aplicació:
La segona obrirà la documentació en un fitxer PDF que es pot imprimir posteriorment. El contingut en ambdós casos és exactament el mateix.
L'última entrada obrirà doc.openerp.com en una pestanya nova de l'aplicació. Premeu la tecla de Control si voleu que s'obri al navegador predeterminat del sistema.
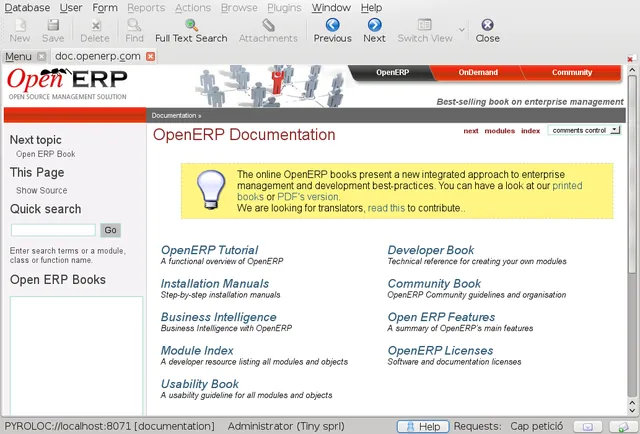
Com podeu veure, a la primera i l'última opcions, els botons anterior i següent, així com el de recàrrega, de la interfície estàndard s'utilitzen com els botons habituals del navegador. De fet, les accions d'URL s'obren ara dins de Koo per defecte, excepte si l'usuari prem la tecla de Control, com ja s'ha esmentat.
Nota: Tot i que la documentació sol ser HTML, no cal obrir cap port nou a OpenERP perquè Koo utilitzarà el vostre protocol preferit (XML-RPC, Net-RPC o Pyro) per carregar HTML i imatges mitjançant un nou protocol intern:
openerp://.
Encara que el que hem vist a la primera opció és el que tots estem acostumats a veure en obrir un manual, no és gaire útil. Si volguéssim llegir el manual sencer, podríem imprimir la seva versió PDF, però res més. De fet, el més habitual seria buscar informació al manual, com ara un camp o una entrada de menú.
Amb el nou marc, els usuaris obriran gairebé sempre el manual mitjançant la nova interfície contextual. La idea és que els usuaris puguin veure les parts del manual que fan referència a la feina que estan fent en aquell moment.
Això té l'avantatge que els redactors de documentació escriuran un sol llibre, amb informació estructurada com un llibre, que es pot llegir de principi a fi. Alhora, es garanteix que la documentació sigui útil perquè els usuaris seran dirigits a les seccions que necessiten quan les necessiten.
La interfície contextual actualment està disponible en un parell de llocs.
El primer lloc on els usuaris se n'adonaran és el nou botó Ajuda afegit a la barra d'estat. Això proporcionarà ajuda per a les entrades de menú:
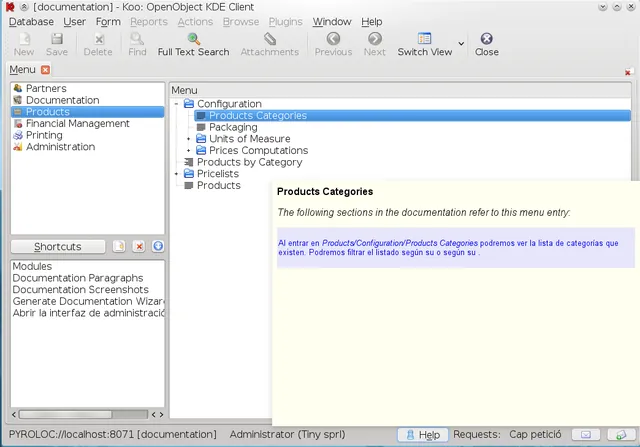
Aquí, els usuaris poden veure els paràgrafs de la documentació on es fa referència al menú.
També proporciona ajuda per a les vistes:
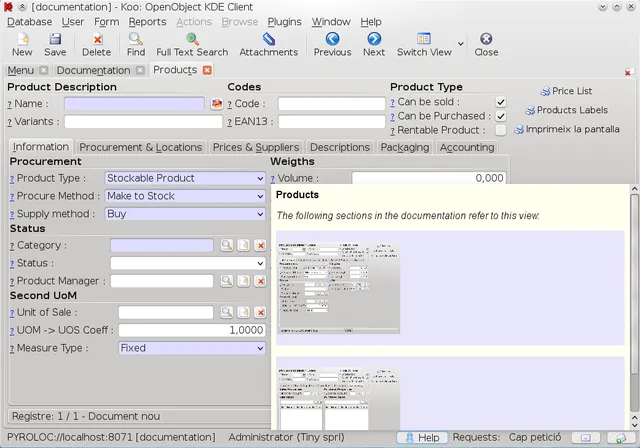
Aquí, els usuaris poden veure els llocs que contenen captures de pantalla de la vista. En ambdós casos, els usuaris poden fer clic i veure la secció adequada a la documentació:
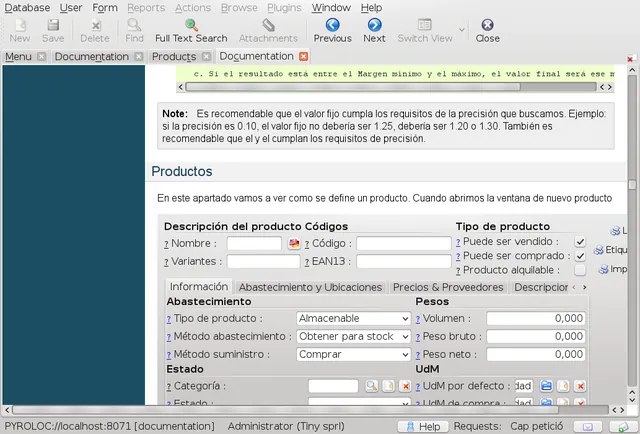
El segon lloc on hem afegit informació contextual és als camps.
Fins ara, només els camps amb un consell tenien un signe d'interrogació. Ara hem afegit el signe d'interrogació a tots els camps. Els que tenen un consell es mostren en blau i els que no en tenen, en negre.
En fer clic al signe d'interrogació es mostra no només el consell, sinó també tots els llocs de la documentació on s'esmenta el camp:
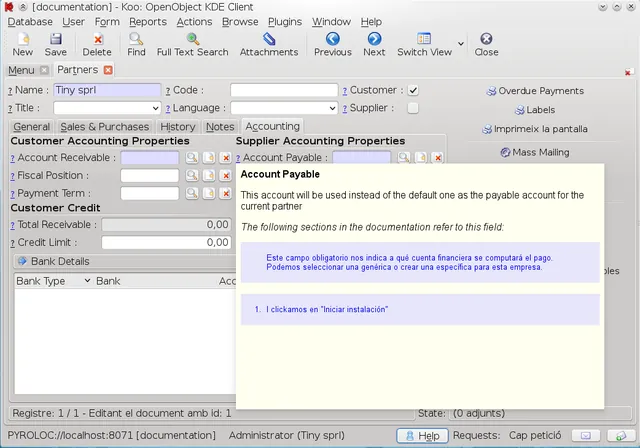
Això és tot el que hem implementat fins ara.
Una altra característica que ens agradaria introduir és la capacitat de veure els llocs on s'esmenta l'estat actual del flux de treball del document actual. Això permetria als usuaris entendre completament què significa factura oberta, per exemple.
Tot i que tot això està orientat a l'usuari, també creiem que el marc s'hauria d'utilitzar per incloure informació per a desenvolupadors. Els integradors també podrien afegir totes les notes i documentació generades durant el procés d'integració per a un client determinat.
La documentació només mostrarà informació rellevant per als mòduls que estiguin instal·lats en aquell moment. Les captures de pantalla també reflectiran el que l'usuari pot veure realment.
Per exemple, si l'usuari pertany a un grup que no pot veure certs camps, aquests camps no apareixeran a les seves captures de pantalla, encara que apareguin per a altres usuaris.
Escriure-la
Estructura
Cada mòdul nou pot tenir (i esperem que puguem fer-ho un requisit) un directori doc. La documentació s'escriu amb sintaxi Sphinx més algunes extensions, de manera que cal tenir Sphinx instal·lat al servidor.
Això garanteix que la documentació es mantingui propera al codi i que els desenvolupadors s'hi sentin còmodes, alhora que sigui intel·ligible per als redactors de documentació.
S'espera que el directori doc contingui un o més fitxers .rst.
Alternativament, si el mòdul proporciona documentació per a altres mòduls, pot tenir un subdirectori modules que contingui la documentació per a cada mòdul que cobreixi.
No us preocupeu si heu de llegir aquesta frase dues vegades; se'm va acudir i la vaig escriure ;-).
Per exemple, com que nosaltres, a NaN, no tenim accés de commit al repositori d'addons, hem creat documentació per als mòduls base, product i account.
Si el mòdul s'anomena addons_doc, el directori serà així:
text
addons_doc/doc/
addons_doc/doc/modules/
addons_doc/doc/modules/base/
addons_doc/doc/modules/product/
addons_doc/doc/modules/account/
Si un mòdul proporciona documentació per a altres mòduls i, per tant, té un directori doc/modules/, qualsevol altre fitxer directament dins de doc/ serà ignorat.
Si volguéssim proporcionar documentació per al mateix mòdul addons_doc, afegiríem un nou directori per a ell dins de addons_doc/doc/modules.
He esmentat que la sintaxi d'aquests fitxers és Sphinx més algunes extensions. Hi ha dos tipus d'etiquetes d'extensió:
- Substitucions
- Identificadors
Substitucions
Les substitucions permeten omplir informació de la documentació amb contingut de la base de dades que l'usuari està executant.
Actualment, s'implementen els tres tipus de substitució següents.
Camps
Utilitzeu la sintaxi següent:
text
/// f: res.partner.name ///
Substituirà l'etiqueta per l'etiqueta del camp ( Nom en aquest exemple, quan l'idioma de sortida és l'anglès).
La referència del camp es compon del model i el nom del camp, separats per un punt.
També podeu imprimir el text d'ajuda del camp amb la sintaxi següent:
text
/// f: res.partner.name : help ///
En ambdós casos, el sistema crearà un àncora immediatament abans del paràgraf actual, permetent trobar aquesta ocurrència del camp a l'HTML generat.
Menús
Utilitzeu la sintaxi següent:
text
/// m: base.menu_ir_sequence_form ///
Substituirà l'etiqueta pel nom complet del menú:
text
Administration/Configuration/Sequence/Sequence
La referència del menú utilitza la sintaxi model-dades a la qual la majoria de desenvolupadors estan acostumats als fitxers XML de vista.
Aquest valor és fàcil d'obtenir a Koo:
- Seleccioneu l'entrada de menú.
- Feu clic a Canvia la vista.
- Feu clic a Plugins/Cerca dades del model al menú superior.
El sistema també crearà un àncora immediatament abans del paràgraf actual.
En el futur, farem possible obrir l'entrada de menú directament des de la mateixa documentació.
Vistes
Utilitzeu la sintaxi següent:
text
/// v: base.sequence_view ///
Substituirà l'etiqueta per una captura de pantalla de la vista. En aquest cas, generaria la imatge següent:
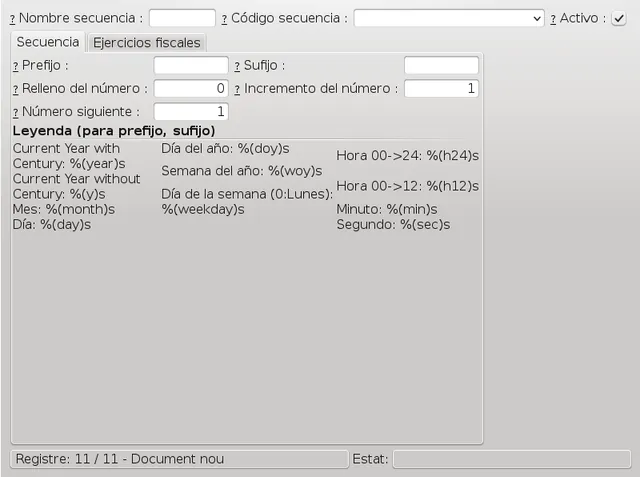
Com amb els menús, la referència segueix la sintaxi model-dades.
També podeu afegir un modificador:
text
/// v: base.sequence_view : fiscal_ids ///
Quan el sistema generi la captura de pantalla, s'assegurarà que es mostri el camp fiscal_ids, encara que no estigui a la primera pestanya.
En aquest exemple, la imatge generada seria així:
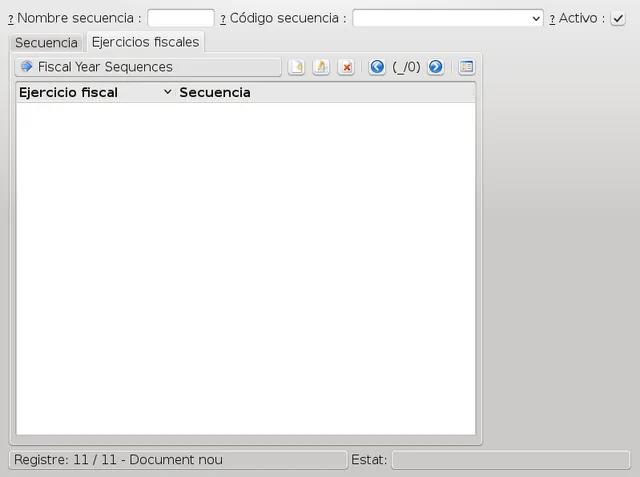
Això és útil perquè no sabem quantes pestanyes hi haurà quan es renderitzi la documentació. El camp que es discuteix també pot haver estat mogut a un altre lloc.
Aquesta funcionalitat no impedeix que els redactors de documentació afegeixin altres captures de pantalla o imatges. Haurien d'afegir-les de la mateixa manera que ho farien normalment amb Sphinx, i es renderitzaran correctament.
El sistema també s'assegurarà que els noms dels fitxers no col·lisionin, de manera que els usuaris no s'han de preocupar per això.
Exemple
Amb aquestes explicacions, ja podem entendre un exemple senzill que podria servir com a part de la documentació del mòdul base.
El fitxer index.rst:
```rst Manual d'OpenERP ================
Contingut:
.. toctree:: :maxdepth: 2 :numbered:
base.rst ```
Com podeu veure, index.rst diu a Sphinx que carregui el fitxer base.rst, que podria ser així:
```rst Configuració ============
Seqüències
A /// m: base.menu_ir_sequence_form /// podeu gestionar les seqüències que permeten als usuaris avançats determinar com es generaran els números de document.
/// v: base.sequence_view /// ```
Identificadors
Els identificadors segueixen aquesta sintaxi:
```text ||| nom_identificador_que_vull |||
Aquí comença el paràgraf al qual volem assignar aquest identificador. ```
Haurien d'aparèixer al principi d'un paràgraf. El paràgraf mateix hauria de començar a la següent línia o a la següent línia no buida.
Les etiquetes d'identificador permeten assignar un ID a cada paràgraf, de manera similar al que fan els desenvolupadors amb les vistes, tot i que els identificadors no són obligatoris.
Si els redactors de documentació no proporcionen un identificador per a un paràgraf, el sistema en crearà un automàticament.
Per crear-lo, el sistema utilitzarà les primeres paraules del paràgraf i afegirà un número si cal per assegurar que l'ID sigui únic dins del seu mòdul.
Els identificadors també poden seguir aquesta sintaxi:
```text ||| : after : base.base_rst |||
product.rst ```
En aquest cas, l'identificador del paràgraf es crearà automàticament.
Alternativament, podeu proporcionar un identificador explícitament:
```text ||| add_product_rst : after : base.base_rst |||
product.rst ```
En ambdós casos, estem dient al sistema que afegim el paràgraf (que en aquest cas simplement conté product.rst) immediatament després del paràgraf amb l'identificador base.base_rst.
Això significa el paràgraf amb l'ID base_rst al mòdul base.
Mirant l'exemple anterior, notareu que estem afegint un nou fitxer product.rst al fitxer index.rst creat pel mòdul base. Com haureu endevinat, aquesta documentació formaria part del mòdul product.
La secció de col·locació de l'etiqueta d'identificador pot utilitzar actualment qualsevol dels valors següents:
beforeafterprependappendreplace
Les opcions before i after creen nous paràgrafs i, per tant, afegeixen una línia buida entre el nou paràgraf i l'heretat.
Les opcions prepend i append no creen nous paràgrafs.
Aquest mecanisme d'herència proporciona una gran flexibilitat i ajuda a evitar el problema condicional if esmentat al meu article anterior del blog.
No obstant això, com que els paràgrafs s'utilitzen com a referències, els redactors de documentació ho haurien de tenir en compte a l'hora d'estructurar el contingut.
Per exemple, a Sphinx, una llista de definicions es pot escriure així:
rst
paraula1
 explicació 1
paraula2
 explicació 2
O així:
```rst paraula1 explicació 1
paraula2 explicació 2 ```
Ambdues versions són vàlides a Sphinx i en aquest marc.
No obstant això, la segona proporciona més flexibilitat si algú crea un mòdul nou i necessita afegir una nova entrada entre paraula1 i paraula2.
Els identificadors creats automàticament poden canviar amb el temps si no es configuren manualment, ja que les primeres paraules d'un paràgraf poden modificar-se.
Per aquest motiu, tenim previst permetre que el sistema emmagatzemi els ID generats automàticament als fitxers .rst originals.
Això permetrà als redactors de documentació corregir errors tipogràfics o reestructurar frases lliurement sense trencar la documentació que pertany a mòduls dependents. També eliminarà la necessitat de crear manualment un ID únic per a cada paràgraf.
A part de conèixer una mica de Sphinx, això és tot el que necessiteu saber per escriure documentació per a aquest marc.
Com funciona
A la secció anterior, hem explicat que la documentació residirà dins dels mòduls, molt a prop del codi font.
Aquí, explicarem què fa el sistema i els passos necessaris per importar i renderitzar la documentació.
Després d'instal·lar el mòdul documentation a OpenERP, apareixerà una nova entrada Documentació al menú principal.
La primera cosa que hauríeu de fer és executar l'Assistent d'Importació de Documentació.
Aquest assistent comprova el directori doc/ de cada mòdul i importa els fitxers .rst a la base de dades d'OpenERP, paràgraf per paràgraf.
Com s'ha esmentat anteriorment, el sistema considera que un paràgraf acaba i un de nou comença després de cada línia buida.
Un cop importats els paràgrafs, podeu veure'ls a l'entrada de menú Paràgrafs de Documentació.
A continuació, hauríeu de:
- Obrir Paràgrafs de Documentació.
- Seleccionar tots els paràgrafs.
- Executar l'acció Plugins/Crea captures de pantalla al menú superior.
No cal explicar què fa aquesta acció, suposo.
Finalment, executeu l'Assistent de Generació de Documentació. La documentació estarà llesta per utilitzar.
Traduir-la
L'assistent d'importació afegirà un registre a ir.data.model per a cada paràgraf.
Això significa que quan creeu un fitxer .pot de plantilla de traducció per a un mòdul, la documentació també s'exportarà.
Fàcil.
El procés de traducció també es simplifica perquè el redactor original ja ha utilitzat etiquetes per fer referència a menús i camps.
Com a resultat, els traductors no han de determinar els noms exactes assignats a aquests elements en la seva llengua.
El mateix s'aplica a les captures de pantalla, ja que es generaran automàticament en l'idioma de l'usuari per a cada instal·lació.
El futur
Ja hem esmentat algunes de les millores que ens agradaria fer, com ara referències als fluxos de treball i les seves activitats, o la possibilitat d'obrir entrades de menú des de la mateixa documentació.
Altres idees inclouen:
- Evitar forçar els usuaris a obrir la secció de Paràgrafs i seleccionar tots els paràgrafs abans de crear captures de pantalla.
- Regenerar la documentació quan sigui necessari sense que l'usuari se n'adoni o ho sol·liciti.
- Integrar la importació de documentació amb la instal·lació de mòduls perquè no calgui un procés d'importació separat.
- Permetre als usuaris afegir les seves pròpies notes dins la documentació, ja que tendeixen a utilitzar la seva pròpia terminologia i seguir els seus propis processos.
- Afegir un apèndix amb informació tècnica sobre els mòduls instal·lats al sistema.